SLA & Service Level
Disaster-Recovery-Tests im Cloud-Vertrag: RTO, RPO und Wiederanlauftests verbindlich regeln
Disaster-Recovery-Tests im Cloud-Vertrag: So regelst du RTO, RPO, Tests, Nachweise und Abhilfe bei Ausfällen verbindlich.
 KI-generiert
Am Montagmorgen ist die zentrale Cloud-Anwendung zwar wieder erreichbar, doch die Daten des vergangenen Arbeitstags fehlen. Der Anbieter meldet eine erfolgreiche Wiederherstellung. Für dein Unternehmen bedeutet das dennoch Nacharbeit, unvollständige Aufträge, fehlerhafte Auswertungen und möglicherweise einen manuellen Abgleich aus E-Mails und lokalen Dateien. Die vereinbarte Verfügbarkeit hilft in dieser Situation kaum weiter. Entscheidend ist, wie schnell die Anwendung tatsächlich wieder produktiv läuft und wie viele Daten höchstens verloren gehen dürfen.
Disaster Recovery gehört deshalb nicht als allgemeine Zusage in eine Leistungsbeschreibung, sondern in klar messbare Vertragsregelungen. Ein Cloud-Anbieter kann eine hohe monatliche Verfügbarkeit erreichen und trotzdem bei einem schwerwiegenden Infrastrukturfehler, einem Ransomware-Angriff oder einem fehlerhaften Update nur langsam oder mit erheblichem Datenverlust wiederherstellen. Bei uns sehen wir regelmäßig, dass gerade diese Lücke erst im Ernstfall auffällt.
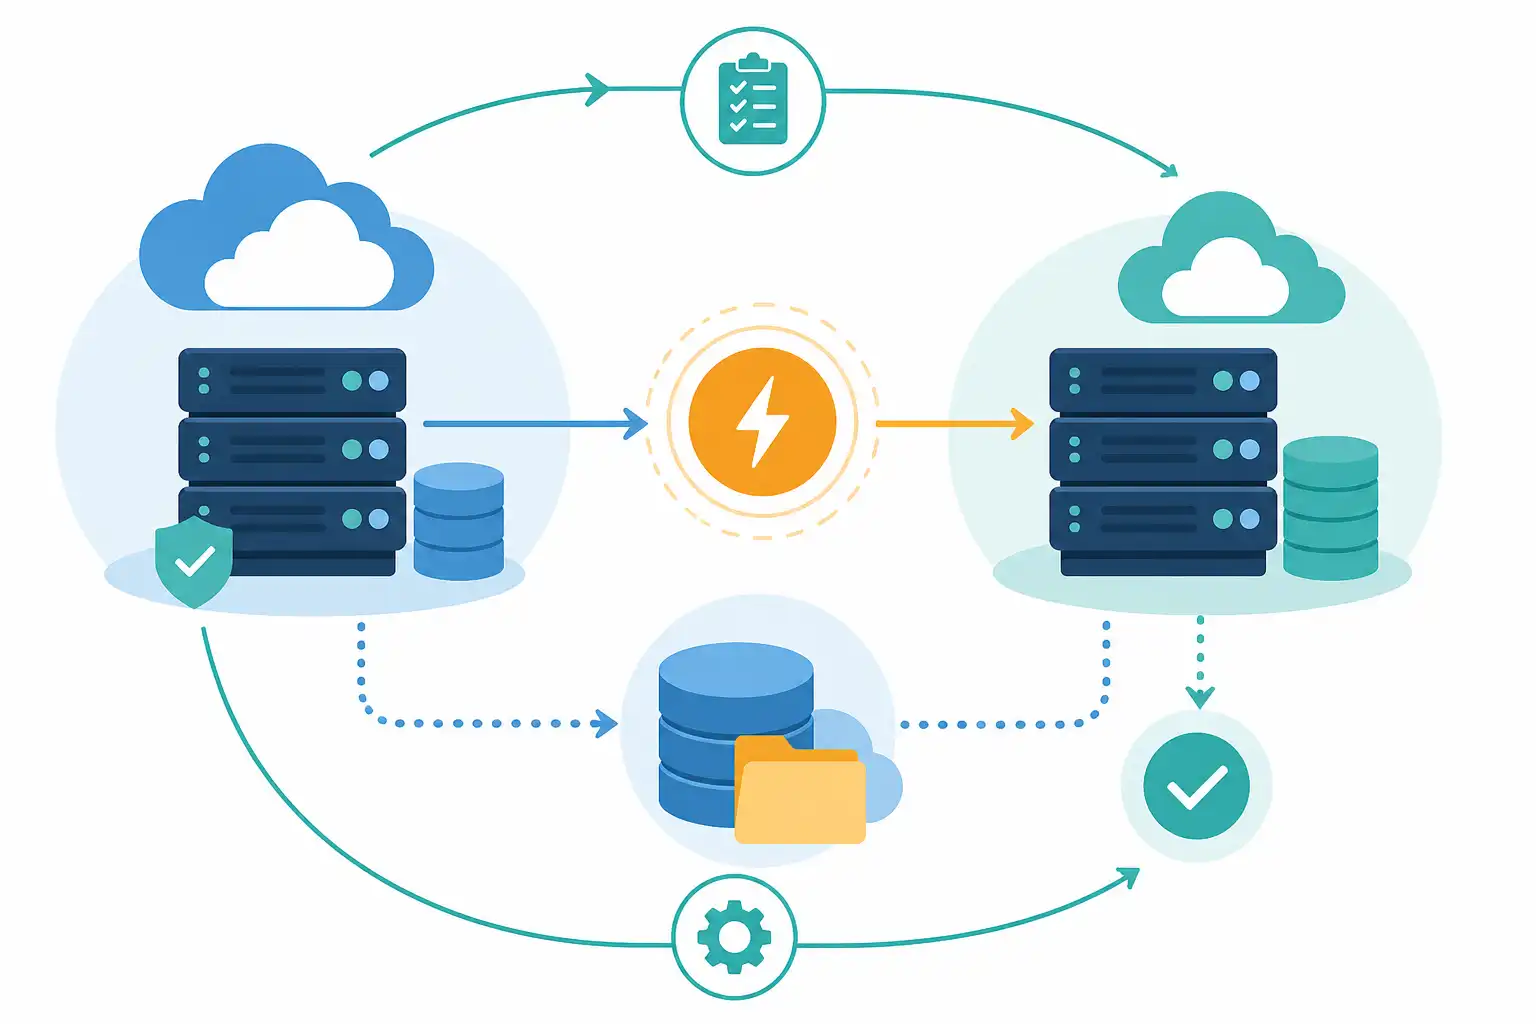
Infografik zu Disaster-Recovery-Tests im Cloud-Vertrag: RTO, RPO und Wiederanlauftests verbindlich regeln (KI-generiert).
Verfügbarkeit, RTO und RPO sauber voneinander trennen
Die Verfügbarkeit beschreibt, wie lange ein Dienst innerhalb eines Messzeitraums nutzbar ist. Sie beantwortet nicht, wie der Anbieter nach einem Totalausfall vorgeht. Eine Verfügbarkeitszusage von 99,9 Prozent sagt weder etwas über die Wiederherstellungsdauer noch über den Stand der wiederhergestellten Daten aus.
Für den Wiederanlauf brauchst du mindestens zwei Zielwerte:
- RTO, Recovery Time Objective: Die maximal zulässige Zeit vom definierten Beginn eines Ausfalls bis zur Wiederherstellung des vereinbarten Betriebszustands.
- RPO, Recovery Point Objective: Der maximal zulässige Datenverlust, gemessen als Zeitspanne zwischen dem letzten wiederherstellbaren Datenstand und dem Eintritt des Schadensereignisses.
Ein RTO von vier Stunden bedeutet nicht automatisch, dass nach vier Stunden alle Geschäftsprozesse uneingeschränkt funktionieren. Der Vertrag muss deshalb festlegen, welcher Zustand erreicht sein muss. Möglich sind etwa die technische Erreichbarkeit, die Anmeldung der Nutzer, die Verarbeitung neuer Vorgänge, die Wiederherstellung von Schnittstellen oder der vollständige Abgleich von Datenbeständen.
Ein RPO von einer Stunde bedeutet entsprechend nicht, dass stündlich irgendein Backup erstellt wird. Entscheidend ist, dass der Anbieter im konkreten Wiederherstellungsfall einen Datenstand bereitstellen kann, der höchstens eine Stunde vor dem Schadensereignis liegt. Replikationsverzögerungen, Sicherungsfehler und nicht konsistente Datenbanken können dieses Ziel gefährden.
Wie Verfügbarkeit und Reaktionszeiten im SLA voneinander abgegrenzt werden, erläutern wir auch im Beitrag Verfügbarkeit und Reaktionszeiten im SLA. Für Disaster Recovery reicht es jedoch nicht, nur Störungsmeldung und Reaktionszeit zu definieren.
Den Auslöser der Wiederanlaufzeit eindeutig bestimmen
Eine häufige Streitfrage lautet: Wann beginnt die RTO-Uhr zu laufen? Anbieter knüpfen sie teils an die formelle Qualifizierung als schwerwiegender Vorfall. Kunden erwarten dagegen, dass sie ab der tatsächlichen Nichtverfügbarkeit zählt. Ohne Definition können zwischen Ausfall und Beginn der Wiederherstellung wertvolle Stunden verloren gehen.
Regle deshalb mindestens diese Punkte:
- Welche Ereignisse einen Disaster-Recovery-Fall auslösen, etwa vollständiger Verlust einer Region, Ausfall zentraler Plattformkomponenten, nicht behebbarer Datenbankfehler, Ransomware-Verdacht oder Verlust von Verschlüsselungsschlüsseln.
- Wer den Fall ausrufen darf und innerhalb welcher Frist der Anbieter eine Entscheidung treffen muss.
- Ab welchem objektiv nachweisbaren Zeitpunkt RTO und Kommunikationspflichten beginnen.
- Welche Systeme, Mandanten, Datenbanken, Schnittstellen und Identitätsdienste vom Wiederanlauf umfasst sind.
- Welche Abhängigkeiten der Anbieter voraussetzt, etwa Netzwerkzugänge, DNS, Identitätsprovider oder kundenseitige Freigaben.
Sinnvoll ist eine Formulierung, nach der die RTO mit der Feststellung der betriebsrelevanten Nichtverfügbarkeit beginnt, spätestens aber mit Eingang der Störungsmeldung beim Anbieter. Für besondere Szenarien kann eine gesonderte Eskalationsentscheidung vorgesehen werden. Diese darf jedoch nicht dazu führen, dass der Anbieter den Beginn beliebig hinauszögert.
RTO und RPO nach Kritikalität staffeln
Ein einheitlicher Wert für alle Anwendungen ist selten passend und oft unnötig teuer. Ordne Services und Daten deshalb in Wiederanlaufklassen ein. Maßstab sind die geschäftlichen Folgen eines Ausfalls, nicht allein die technische Bedeutung einer Anwendung.
| Wiederanlaufklasse | Typische Systeme | Vertragsinhalt |
|---|---|---|
| Kritisch | Auftragsabwicklung, Produktion, zentrale Identitätsdienste | Kurzes RTO, enges RPO, priorisierte Wiederherstellung, regelmäßige Tests |
| Hoch | Kundenportale, Finanzprozesse, zentrale Fachanwendungen | Verbindliche Ziele und definierte Abhängigkeiten |
| Standard | Kollaboration, interne Fachverfahren | Angemessene Wiederanlaufziele, standardisierte Tests |
| Niedrig | Archive, Testsysteme, selten genutzte Daten | Längere Wiederherstellungszeiten und reduzierte Sicherungsintervalle möglich |
Die Tabelle gehört nicht nur in ein internes Notfallkonzept. Sie sollte Vertragsanlage werden und die betroffenen Services eindeutig bezeichnen. Bei SaaS-Angeboten genügt die Produktbezeichnung häufig nicht, weil einzelne Funktionen, Speicherbereiche oder Schnittstellen unterschiedliche technische Grundlagen haben können.
Achte außerdem darauf, ob der Anbieter RTO und RPO lediglich als Zielwerte oder als verbindliche Leistungspflichten beschreibt. Zielwerte ohne Folgen bei Nichteinhaltung sind oft eher Planungsannahmen. Wenn der Anbieter nur „wirtschaftlich angemessene Bemühungen“ zusagt, bleibt offen, welches Ergebnis du tatsächlich verlangen kannst.
Wiederanlauftests konkret vereinbaren
Ein Backup ist kein Nachweis für Wiederherstellbarkeit. Erst ein Test zeigt, ob Sicherungen lesbar, Daten konsistent, Zugriffsrechte vorhanden und Schnittstellen wieder funktionsfähig sind. Der Vertrag sollte deshalb nicht pauschal „regelmäßige Tests“ verlangen, sondern Testart, Rhythmus, Prüftiefe und Nachweise bestimmen.
Für kritische Services kommen insbesondere diese Testformen in Betracht:
- Wiederherstellung einzelner Datenbestände oder Mandanten.
- Wiederanlauf einer Anwendung in einer getrennten Testumgebung.
- Umschaltung auf eine alternative Region oder Ersatzumgebung.
- Szenariobasierter Test nach Cyberangriff, einschließlich Wiederherstellung aus einem unveränderbaren Sicherungsbestand.
- Gemeinsamer End-to-End-Test mit deinen Schnittstellen, Identitätsdiensten und fachlichen Abnahmen.
Die Häufigkeit richtet sich nach Risiko und Veränderungsrate. Ein jährlicher Test kann für eine wenig kritische Anwendung genügen, für geschäftskritische Plattformen aber zu wenig sein. Entscheidend ist auch der Anlassbezug: Nach wesentlichen Architekturänderungen, Migrationen, Wechseln des Backup-Verfahrens oder gravierenden Sicherheitsvorfällen sollte ein zusätzlicher Test geschuldet sein.
Bei Ransomware-Szenarien reicht es nicht, nur virtuelle Maschinen zu starten. Es muss geprüft werden, ob der Wiederherstellungspunkt frei von Schadcode ist, ob Administratorzugänge gesichert wurden und ob die Anwendung mit ihren Daten wieder konsistent arbeitet. Dazu passt unser Beitrag Ransomware-Notfallhilfe im IT-Supportvertrag: Reaktionszeiten, Forensik und Wiederanlauf verbindlich regeln.
Testnachweise so gestalten, dass sie belastbar sind
Fordere nicht nur eine Bestätigung des Anbieters an. Ein brauchbarer Testbericht dokumentiert, was genau geprüft wurde und welche Grenzen der Test hatte. Andernfalls lässt sich aus einem positiven Ergebnis nicht ableiten, ob deine vereinbarten Ziele erfüllt wurden.
Der Bericht sollte mindestens enthalten:
- Datum, Testumgebung und beteiligte Komponenten.
- Testfall und Ausgangslage, einschließlich angenommener Schadensursache.
- Gemessene Dauer bis zu den einzelnen Wiederanlaufschritten.
- Tatsächlich erreichter Datenstand und daraus abgeleitetes RPO.
- Abweichungen, Fehler, manuelle Eingriffe und nicht getestete Abhängigkeiten.
- Maßnahmenplan mit Verantwortlichen und Termin für die Nachprüfung.
Vereinbare ein Einsichtsrecht in die relevanten Nachweise und bei kritischen Services eine gemeinsame Teilnahme oder Beobachtung. Dabei musst du nicht zwingend Zugang zu fremden Kundenumgebungen erhalten. Der Anbieter kann Testprotokolle, anonymisierte technische Nachweise und eine fachliche Demonstration kombinieren. Wichtig ist, dass die Nachweise dein konkretes Vertragsverhältnis und nicht nur eine allgemeine Plattformbeschreibung betreffen.
Abhilfepflichten und Eskalation gehören in den Vertrag
Ein nicht bestandener Test darf nicht folgenlos bleiben. Lege fest, wann eine Abweichung vorliegt und welche Korrekturpflichten daraus entstehen. Als Abweichung kommen etwa die Überschreitung von RTO oder RPO, fehlende Datenkonsistenz, nicht erreichbare Schnittstellen oder eine unvollständige Dokumentation in Betracht.
Der Anbieter sollte dann innerhalb einer vereinbarten Frist eine Ursachenanalyse und einen Abhilfeplan vorlegen. Der Plan sollte technische Maßnahmen, Verantwortliche, einen Terminplan und einen Wiederholungstest enthalten. Bei kritischen Mängeln kann eine kurzfristige Eskalation bis zur Managementebene erforderlich sein.
Servicegutschriften können einen Anreiz zur Einhaltung schaffen, ersetzen aber keinen funktionierenden Wiederanlauf. Sie sollten deshalb nicht die einzige Rechtsfolge sein. Je nach Risiko können zusätzlich Sonderkündigungsrechte, Zurückbehaltungsrechte oder Verpflichtungen zur Unterstützung beim Wechsel relevant sein. Wie solche Mechanismen im SLA sinnvoll ausgestaltet werden, behandeln wir im Beitrag Pönale und Servicegutschriften im SLA.
Verantwortlichkeiten des Kunden nicht übersehen
Auch dein Unternehmen trägt häufig Pflichten, die den Wiederanlauf beeinflussen. Dazu zählen aktuelle Ansprechpartner, getestete Zugänge, klare Datenklassifizierung, Freigaben für Notfallmaßnahmen und die Bereitstellung eigener Schnittstellen. Diese Mitwirkungen müssen realistisch und präzise beschrieben sein.
Problematisch sind Klauseln, die den Anbieter pauschal von allen RTO- und RPO-Pflichten befreien, sobald eine kundenseitige Komponente beteiligt ist. Besser ist eine differenzierte Regelung: Der Anbieter bleibt für seine Leistungen verantwortlich und darf nur dann Fristen anpassen, wenn eine konkret benannte Mitwirkung nachweislich fehlt und den Wiederanlauf tatsächlich verhindert.
Für Cloud-Dienste sollte auch der Ausstieg vorbereitet sein. Nach einem schweren Vorfall kann ein Anbieterwechsel notwendig werden, selbst wenn die Anwendung kurzfristig wieder läuft. Anforderungen an Datenrückgabe, Formate, Fristen und Unterstützung findest du in unserem Beitrag Exit-Strategie und Datenrückgabe beim Cloud-Anbieter.
Checkliste für deine Vertragsprüfung
Prüfe vor Vertragsabschluss oder bei der nächsten Verlängerung diese Fragen:
- Sind RTO und RPO für jeden kritischen Service und jede relevante Datenklasse verbindlich festgelegt?
- Ist klar definiert, wann die Wiederanlaufzeit beginnt und welcher Betriebszustand am Ende geschuldet ist?
- Umfasst der Wiederanlauf auch Schnittstellen, Identitätsdienste, Berechtigungen und Datenkonsistenz?
- Sind Testarten, Intervalle, zusätzliche Anlass-Tests und Nachweise vereinbart?
- Gibt es konkrete Abhilfefristen und Wiederholungstests nach einem fehlgeschlagenen Test?
- Sind Mitwirkungspflichten beider Parteien verhältnismäßig und nachvollziehbar geregelt?
- Passen Haftung, Servicegutschriften, Kündigungsrechte und Exit-Regelungen zum Schaden eines längeren Ausfalls?
Ein belastbarer Cloud-Vertrag behandelt Disaster Recovery damit als überprüfbare Leistung, nicht als unverbindliches Sicherheitsversprechen. Passende Seminare und Termine findest du bei uns auf cmt.de.
Nächster Schritt
Passenden Kurs zu SLA & Service Level finden.
Feste Termine, erfahrene Trainer, Präsenz in München und Durchführungsgarantie. Buchen kannst du direkt auf cmt.de.
Weiterlesen